一、引言
2025 年 9 月 22 日,我们排查了一次日志查询变慢的问题。该问题可以稳定复现,在测试环境也可复现;现场主要表现为 HTTP 超时,只有部分请求能够返回。41002.2072ms是一次成功返回且被trace捕获的样本,不是边界、上限、最坏耗时、平均值或分位数,不同成功样本的耗时会有波动。此类问题如果一开始就归因于 ClickHouse、网络或线程池,容易偏离方向;更可靠的起点是先确认时间消耗在哪一层调用边界。本文使用 Arthastrace从请求入口逐层收窄范围,并结合后续现场检查还原问题:查询面对一张约 4000 列的 ClickHouse 超宽表,却仍采用“不限字段、先取 1000 条”的策略。文章保留证据边界:trace能定位当前 JVM 内的方法调用路径和节点耗时,但不能凭一条远程调用节点断定远端内部究竟慢在网络、序列化、线程池还是 ClickHouse。
二、正文
(一)从目标 JVM 建立第一层调用证据
Arthas 官方 trace 文档说明,trace 用于观察方法内部的调用路径及各节点耗时,默认一次只跟踪一级方法。输出中的 #行号 是源码调用行号,不是调用深度。现场先下载并启动 Arthas,在交互列表中选择目标 Java 进程:
curl -O https://arthas.aliyun.com/arthas-boot.jar
java -jar arthas-boot.jar
attach 后,最初直接监听搜索实现的方法:
trace com.eoitek.aimeter.log.search.SplServiceImpl query第一次只有 Affect 行:
Affect(class count: 1, method count: 1) cost in 744 ms, listenerId: 2这表示监听已安装,但方法尚未被新请求触发,并不表示方法没有调用或没有耗时。trace 通常需要在安装监听后重新发起对应请求,才能得到调用树。
为确认请求是否经过预期入口,现场改为跟踪上层 Controller:
trace com.eoitek.aimeter.log.query.QueryControllerV2 search触发查询后得到第一层回显。以下为现场原始回显:
[arthas@14016]$ trace com.eoitek.aimeter.log.query.QueryControllerV2 search
Press Q or Ctrl+C to abort.
Affect(class count: 2 , method count: 2) cost in 195 ms, listenerId: 3
`---ts=2025-09-22 16:07:01.957;thread_name=XNIO-2 task-3;id=303;is_daemon=false;priority=5;TCCL=sun.misc.Launcher$AppClassLoader@18b4aac2
    `---[1767.7274ms] com.eoitek.aimeter.log.query.QueryControllerV2$$EnhancerBySpringCGLIB$$9659538d:search()
        `---[99.97% 1767.2482ms ] org.springframework.cglib.proxy.MethodInterceptor:intercept()
            `---[97.60% 1724.7655ms ] com.eoitek.aimeter.log.query.QueryControllerV2:search()
                +---[0.00% 0.0406ms ] com.eoitek.aimeter.log.search.api.SplV4Service:validateEventTypePermission() #52
                +---[35.16% 606.5012ms ] com.eoitek.aimeter.log.search.api.SplV4Service:buildUnionReq() #53
                +---[64.79% 1117.5058ms ] com.eoitek.aimeter.log.search.api.SplV4Service:search() #54
                +---[0.00% 0.0111ms ] com.eoitek.aimeter.common.feign.uq.model.UnionReq:getQuery() #55
                +---[0.03% 0.5098ms ] org.slf4j.Logger:info() #55
                `---[0.00% 0.0064ms ] com.eoi.framework.cola.dto.Result:success() #56
该采样中,入口总耗时为 1767.7274ms,buildUnionReq() 占 606.5012ms,搜索服务占 1117.5058ms。这不足以解释几十秒的慢查询,但足以将下一步范围收窄至搜索服务。
(二)下钻搜索服务,确认远程调用边界等待
继续跟踪搜索服务实现:
trace com.eoitek.aimeter.log.search.SplV4ServiceImpl search另一成功返回样本中,方法总耗时 383.968ms,远程调用节点耗时 382.8315ms,占 99.70%。以下为现场原始回显:
`---ts=2025-09-22 16:09:55.928;thread_name=XNIO-2 task-5;id=307;is_daemon=false;priority=5;TCCL=sun.misc.Launcher$AppClassLoader@18b4aac2
    `---[383.968ms] com.eoitek.aimeter.log.search.SplV4ServiceImpl:search()
        +---[0.02% 0.0868ms ] com.eoi.framework.common.util.JsonUtil:toJsonPretty() #176
        +---[0.15% 0.5651ms ] org.slf4j.Logger:info() #176
        +---[99.70% 382.8315ms ] com.eoitek.aimeter.common.feign.uq.gateway.IUqGateway:search() #177
        +---[0.09% 0.3414ms ] org.slf4j.Logger:info() #178
        +---[0.00% 0.0042ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #179
        +---[0.00% 0.0051ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp:getMetadata() #179
        +---[0.00% 0.0049ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #180
        +---[0.00% 0.0029ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp:getMetadata() #180
        +---[0.00% 0.0033ms ] com.eoitek.aimeter.common.feign.uq.model.UnionReq:getQuery() #180
        +---[0.00% 0.0031ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp$MetaData:setSpl() #180
        +---[0.00% 0.0042ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:isSuccess() #182
        `---[0.00% 0.0028ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #183
随后捕获到慢样本。该次调用总耗时 41002.2072ms,其中远程查询调用耗时 41000.682699ms,截图显示占比 100.00%:
`---ts=2025-09-22 16:12:29.888;thread_name=XNIO-2 task-7;id=311;is_daemon=false;priority=5;TCCL=sun.misc.Launcher$AppClassLoader@18b4aac2
    `---[41002.2072ms] com.eoitek.aimeter.log.search.SplV4ServiceImpl:search()
        +---[0.00% 0.0607ms ] com.eoi.framework.common.util.JsonUtil:toJsonPretty() #176
        +---[0.00% 0.417301ms ] org.slf4j.Logger:info() #176
        +---[100.00% 41000.682699ms ] com.eoitek.aimeter.common.feign.uq.gateway.IUqGateway:search() #177
        +---[0.00% 0.887199ms ] org.slf4j.Logger:info() #178
        +---[0.00% 0.006201ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #179
        +---[0.00% 0.0058ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp:getMetadata() #179
        +---[0.00% 0.004199ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #180
        +---[0.00% 0.0043ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp:getMetadata() #180
        +---[0.00% 0.004601ms ] com.eoitek.aimeter.common.feign.uq.model.UnionReq:getQuery() #180
        +---[0.00% 0.0047ms ] com.eoitek.aimeter.common.feign.uq.model.SearchResp$MetaData:setSpl() #180
        +---[0.00% 0.004401ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:isSuccess() #182
        `---[0.00% 0.003499ms ] com.eoitek.aimeter.common.feign.uq.model.SplResponseWrapper:getData() #183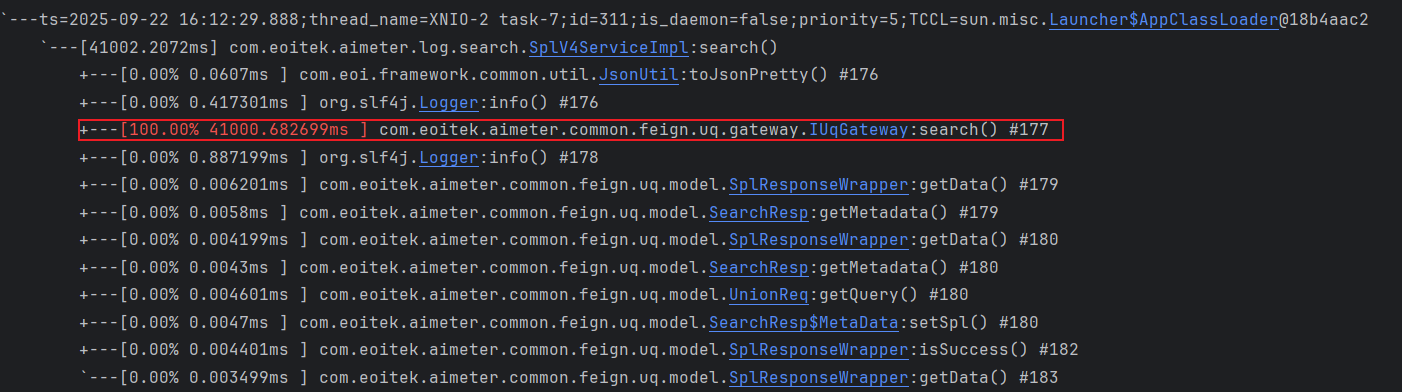
图:41 秒成功返回样本的现场原始 trace 截图,未做脱敏。该结果是一次真实采样,不是平均值,也不是 P95 或 P99,更不应视为上限。
两组成功返回样本共同说明,当前 JVM 内的主要等待落在远程服务调用边界,其中一次成功返回样本在该边界等待了 41 秒;41 秒不应视为上限。但证据必须止于边界:网络传输、序列化、线程池排队和 ClickHouse 执行仍是待检查对象,不能只凭这份 trace 断定远端内部原因。
(三)回到数据形状,识别全字段返回的放大效应
后续现场排查发现,查询对象是一张约 4000 列的 ClickHouse 超宽表。后端 SPL 请求未限制返回字段,实际获取全量字段,并会先取 1000 条记录。该策略隐含“单表通常只有 20 多个字段”的早期假设;迁移到约 4000 列后,数据形状已经完全不同。
前端已有字段过滤和显示配置,因此页面只展示有限字段;但过滤发生在完整响应到达之后,查询、序列化、网络传输和反序列化成本已发生。即使某字段值为空,结构化响应仍需携带字段 key,压力还来自字段名、结构封装及其在查询、传输、解析链路中的累积成本。以 4000 / 20 估算,字段规模约为原假设的 200 倍;这只是数量级推算,不能表述为实测响应体放大了 200 倍。
该表源于客户要求将多个业务系统的日志写入同一张 ClickHouse 表:表内同时包含公共字段与各系统个性字段,每条日志通常只填公共字段和本系统个性字段,其余字段为空值或默认值,最终逐步膨胀到约 4000 列。ClickHouse 官方文档:Designing an Observability Schema 的 OTel 默认模式确有单日志表,并将长尾属性置于 Map 中,也建议按访问模式自定义 schema、将高频 Map key 提升为普通列;这并不等于 ClickHouse 官方推荐把所有个性字段预铺成数千列。
因此,41 秒样本提供的是远程调用边界证据,超宽表和全字段返回来自后续现场排查。两者合并后才能形成更可靠的判断:查询链路处理了远超实际展示与筛选需要的数据形状。不能仅凭 trace 将问题归为 ClickHouse 查询慢,也不能忽略调用方请求了什么数据。
(四)将字段裁剪下推到服务端 SPL 投影
修复不从调大 HTTP 超时开始,而是先验证显式字段投影:让数据源只返回当前展示与筛选真正需要的列。方案复用前端已有的字段显示配置思路,二开服务端“查询结果保留字段”配置;后端读取该配置,校验字段是否存在,并将有效字段真正下发、拼接到 SPL 投影中。由此,数据源仅返回展示和筛选所需列,避免无关字段进入后续查询、传输和解析链路。
| 方案 | 数据源返回 | 链路负担 |
|---|---|---|
| 页面限制显示、后端全字段查询 | 约 4000 列 | 无关字段贯穿全链路 |
| 服务端保留字段配置 + SPL 投影 | 展示、筛选所需列 | 无关字段不进入结果集 |
关键不在“前端最终显示多少列”,而在“数据源最初返回多少列”。先查询全部字段、再在前端或服务末端过滤时,查询和远程传输成本已经发生;只有将投影推到查询源头,才能从数据产生处缩小结果形状。现场未形成可公开的修复前后量化数据,因此只确认修复方向,不宣称具体性能收益。
当时还讨论过 SSE/流式查询作为备选:多批结果逐步返回,由前端拼接,以改善长等待中的首批结果和进度体验。这不是最终修复。参考 ClickHouse HTTP Interface,这里的 SSE 是应用层基于 HTTP 的流式交付方式,不是 ClickHouse SSE;它不能自动减少 ClickHouse 的扫描、计算或总数据量,真正降低负担仍依赖查询字段投影。
(五)沉淀可复用的分层排障步骤
- 确认稳定复现条件并记录代表性样本。 记录单次请求总耗时、发生时间和触发条件,明确它是单次采样还是统计指标,避免将单次值误写为平均值或分位数。
- 从稳定入口开始。 attach 目标 JVM 后,优先
traceController 或明确业务入口;只有Affect行时,重新触发请求,而不是立即判定命令无效。 - 按占时逐层下钻。 在一级调用树中选择占时最高的业务节点,再对其实现方法执行下一次
trace,不要试图用一次命令看穿整条链路。 - 保留不同成功返回样本。 成功返回样本可能存在耗时差异,可用于识别稳定结构和观察放大位置;同时应如实记录主要现场现象是 HTTP 超时,不能据此将问题描述为偶发。
- 在边界处切换证据。 耗时集中到 RPC、HTTP 或数据库客户端边界后,
trace已完成 JVM 内的定位任务;下一步应检查远端日志、查询语句、字段规模和响应形状,而不是从本地调用树推断远端内部原因。 - 让修复靠近数据源。 先以显式字段投影验证判断,再将字段选择配置和 SPL 投影固化进查询链路,只请求展示和筛选字段;实际性能收益仍需独立测量。
现场核心证据来自上述分层 trace。如需辅助观察,可用 -n 限制捕获次数:
trace com.eoitek.aimeter.log.search.SplV4ServiceImpl search -n 5也可用条件表达式只保留高耗时调用:
trace com.eoitek.aimeter.log.search.SplV4ServiceImpl search '#cost>100'sm 可用于确认类的方法信息;watch 官方文档说明,该命令可观察入参、返回值或异常。这些命令只是后续可选辅助,不是本次现场定位的核心证据,也不能替代远端和数据源侧检查。
三、总结
本次排查的价值不在于捕获到一个 41 秒数字,而在于建立清晰的证据顺序:先从 Controller 入口确认请求路径,再下钻到搜索服务,将主要耗时定位到本 JVM 的远程调用边界;随后停止过度推断,通过后续现场检查识别出约 4000 列超宽表与全字段返回造成的数据形状问题。41002.2072ms 的 41 秒成功返回样本不是上限,现有材料也没有超时率、P95/P99 或修复前后量化数据。
修复原则同样直接:页面只显示少量字段,不等于后端只查询少量字段。 应将字段配置从前端展示逻辑下沉到服务端,并进入 SPL 投影,不要先获取大量无关数据再过滤。SSE/流式查询只能作为长等待期间的体验兜底,而非根因修复。对类似慢查询,trace 适合回答本 JVM 内“慢在哪里”,远端日志、查询内容和数据形状则用于回答“为什么慢”。
